AI 大模型来 5 人精品培训班
 汉码未来

 白天班、晚班、周末班等7个班级
【课程详情】
AI 大模型时代,顶实战人才千金难求!唯有掌握全流程核心技术,方能抢占行业金字塔顶端,成为企业疯抢的核心瑰宝。
汉码未来重磅升级 AI 大模型顶流精品课,以 4-5 个月深耕培育,铸就 AI 大神之路,拒绝平庸,只造精英!
5 人私教小班,拒绝大班摆烂,一对一精准赋能,手把手带练,每一位学员都能享受顶配教学资源!
自有专属服务器实验室,硬核硬件加持,全流程实战不玩虚的,打破“纸上谈兵”行业痛点,让你在真实实操中练就碾压同行的硬核本领!
高新技术企业背书,腾讯、网易等权威认可,课程同步行业前沿,带你掌握别人学不到的核心秘籍,轻松拉开差距!
提前 1 个月左右预定学位的同学,住宿免费,5 人精品班,学位有限,定金为准!
【课程主讲内容】
大模型行业前景广阔,薪资水涨船高。一方面大力投入人工智能核心技术研发与人才培养,另一方面企业全面开启“大模型 ”转型,从通用大模型到行业垂类应用,技术融合与产业落地的双重需求,为大模型人才带来了前所未有的发展机遇,精通大模型全链路技术,已成为新时代技术人立足的核心竞争力!
本课程涵盖了从 Python 基础、数据结构与算法、Linux 及 Shell、MySQL、NumPy、Pandas等必备工具,到机器学习核心、深度学习核心、NLP 核心、LangChain、大模型微调核心、企业级 LLM 部署与 RAG、Agent 开发等全链路技术,让学员掌握大模型开发、调优、部署等核心岗位所需的全部技术栈!
学习过程中,咱每个阶段都设置了考核,毕业前让学员脱离老师,真正进行独立实战项目,而且 5 人小班内每个学员的项目不一样,不得抄袭,真正让学员掌握一技之长,能拥有珍贵的独立开发和独立解决问题能力!
学习到最后,毕业答辩+面试指导,为就业助力添彩!就业后遇到技术难题可随时联系老师给出解决思路,工作几年后想跳槽也可联系老师给予内推,终身保技术,保薪资!一次合作,终身朋友!
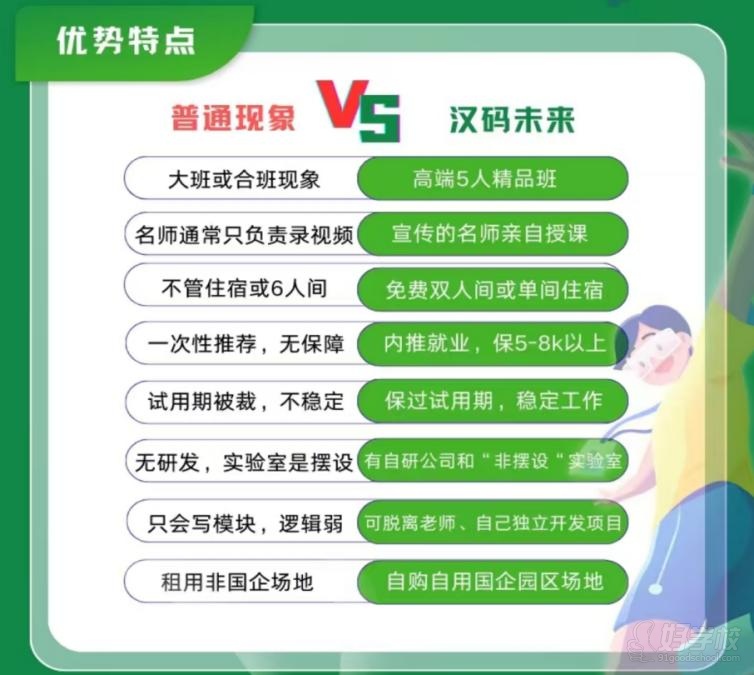
【机构优势】
汉码未来是腾讯/网易/博鳌亚洲论坛,三大官方认证的好口碑优质 IT 品牌,是国内一梯队的老牌 IT 培训机构,主要优势如下:
【常见问答】
对于非计算机专业,不懂编程的小白,想零基础跨行转业的人来说,适合学吗?
可以的,汉码未来的 5 人精品班针对的就是零基础同学,无论你是跨行转业,还是本专业,都可以从零基础参加 5 人精品班。老师会用通俗的语言带领小白由浅入深,循序渐进地学习,顺利地进入 IT 行业。课程标准来源于一二线大厂,掌握后相当于 1-2 年 AI 大模型工作经验,拥有优质的工作能力。
好就业吗?好就业方向有哪些?
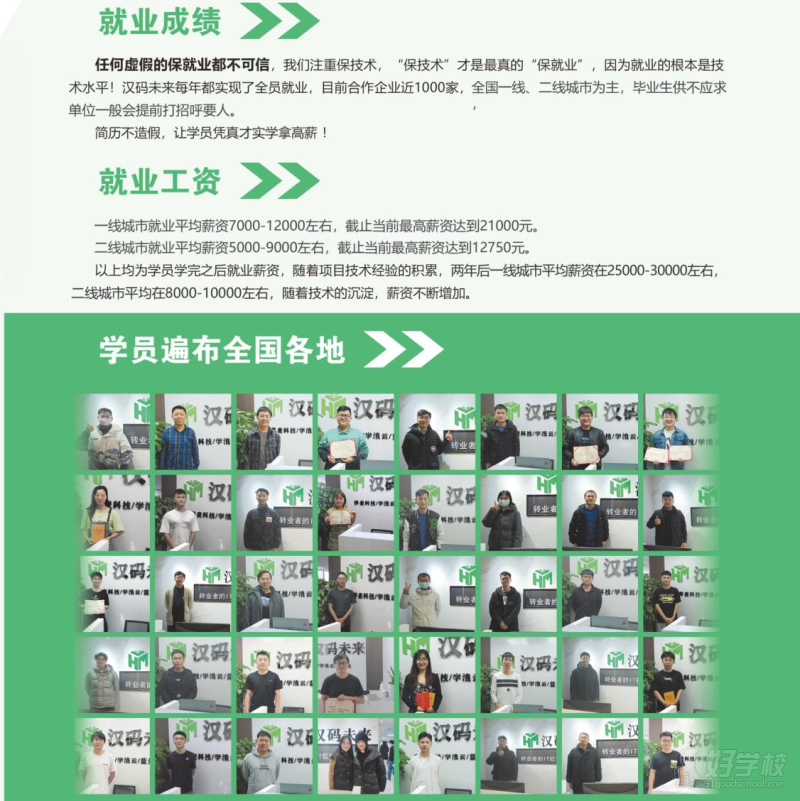
学完后的就业领域涵盖政府机构、金融服务、通信和物联网、教育科研、互联网产业、医疗健康、无人驾驶、智能手机、通信传输、工业控制、数控设备、航空航天设备、游戏等各行各业,职业可以参考大模型开发工程师、数据挖掘工程师、AIGC 算法工程师、大模型 Agent工程师、CV 计算机视觉工程师、Prompt 工程师、大语言模型 LLM 开发工程师、大模型推理工程师、算法工程师、机器学习工程师、智能语音算法工程师、大模型微调工程师、NLP 自然语言处理工程师、多模态工程师等,涉及各行各业,就业面特别广。汉码未来 5 人精品班,保技术,保薪资!
学习时间是多少?学习之后能达到什么水平?
大概需要 4-5 个月左右的时间,当然和每个人的基础水平、接受能力和进度安排都有关,我们不是一刀切的机构,5 人精品班有非常强的灵活把握能力,我们学不会免费重学,直到学会为止,学不好学不会我们也不会让学员走的。一般情况下,每天保持理论课 2-4 小时左右,实践课至少 4-6 小时左右,晚自习 2 小时(不强制),周六开放,周日休息,5 个月左右是可以顺利毕业的。最后可以达到脱离老师,自己独立开发项目的水平,到企业以后可以独当一面!
毕业后的薪资大概是多少?
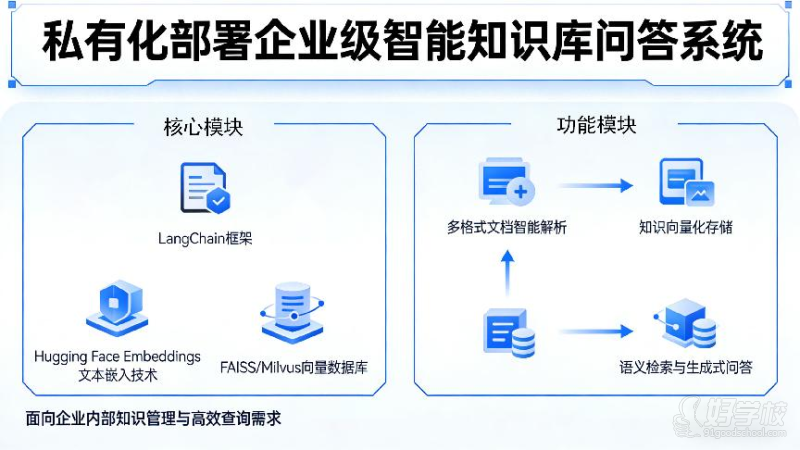
项目一、私有化部署企业级智能知识库问答系统
【项目介绍】
面向企业内部知识管理与高效查询需求,打造私有化部署的智能知识库问答系统,摆脱公有云服务的隐私与合规限制,支持多格式企业文档的存储与智能问答,实现语义级精准检索与生成式回答,适配企业内部知识库、行业资料管理、部门专属知识查询等多场景,为企业打造专属智能知识助手。
【核心技术】
LangChain框架、HuggingFaceEmbeddings文本嵌入技术、FAISS/Milvus向量数据库、PyPDFLoader/Docx2txtLoader多格式文档加载技术、大模型私有化推理(Qwen/ChatGLM)、FastAPI接口开发、Docker容器化部署、Nginx反向代理与负载均衡、用户权限分级管理机制、上下文对话记忆技术。
【功能实现】
1.多格式文档智能解析:支持PDF、Word、TXT、网页等格式文档的批量上传与解析,完成文本提取、冗余内容过滤与结构化处理;
2.知识向量化存储:将解析后的文本进行嵌入向量化,存储至FAISS/Milvus向量数据库,支持知识库增量更新与内容删除;
3.语义检索与生成式问答:接收用户自然语言问题,通过向量库完成相似性检索,结合大模型实现基于企业知识的生成式回答,避免通用大模型幻觉问题;
4.知识点溯源:回答结果关联原文档位置,支持跳转查看知识原文,实现回答可追溯;5.上下文对话:支持多轮对话,记忆历史问题与回答,实现连续的知识咨询;
6.权限分级管理:设置管理员、部门用户、普通用户等不同角色,实现知识库内容的访问与操作权限管控;
7.私有化部署:基于Docker完成系统整体打包,实现企业服务器本地部署,企业知识数据安全。
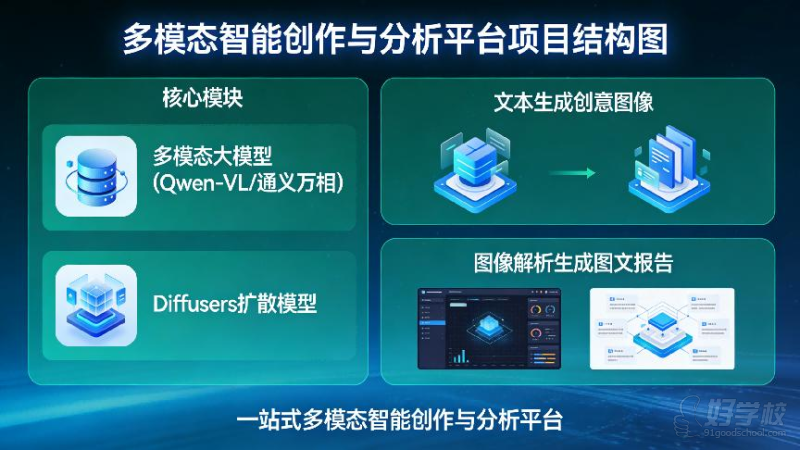
项目二、多模态智能创作与分析平台
【项目简介】
项目融合文本、图像双模态大模型能力,打造多模态智能创作与分析平台,打破单一模态的内容生产与分析局限,适配新媒体创作、电商产品运营、广告设计等商业场景,支持用户通过自然语言实现创意内容生成、图像智能解析、跨模态检索等操作,支持自定义内容风格与解析维度,提升企业内容生产效率与分析深度。
【核心技术】
多模态大模型(Qwen-VL/通义万相)、Diffusers扩散模型、CLIP跨模态对齐技术、LangChain 流程编排、FastAPI前后端接口开发、MySQL业务数据存储、Redis缓存优化、TensorRT推理加速、图像风格定制技术、跨模态相似性检索技术。
【功能实现】
1.文本生成创意图像:用户输入自然语言描述的创作需求,支持自定义图像风格、分辨率、尺寸,通过多模态大模型生成符合需求的创意图像,适配海报、插画、产品示意图等场景;2.图像解析生成图文报告:上传图像后,系统自动解析图像内容、核心要素、视觉特征,生成结构化图文分析报告,适配电商产品分析、广告素材评估等场景;
3.跨模态图文互搜:支持以文搜图、以图搜文,输入文本可检索相似风格/内容的图像,上传图像可检索相关描述文本与素材,实现多模态素材高效检索;
4.产品图智能标注:针对电商产品图像,自动识别产品核心特征、规格、细节,生成标准化产品标注文案,适配电商商品上架场景;
5.创作内容管理:支持生成内容的批量保存、分类、删除,实现多模态创作素材的管理;
6.推理加速优化:基于TensorRT实现多模态模型推理加速,提升图像生成与解析的响应速度,支持高并发请求处理。
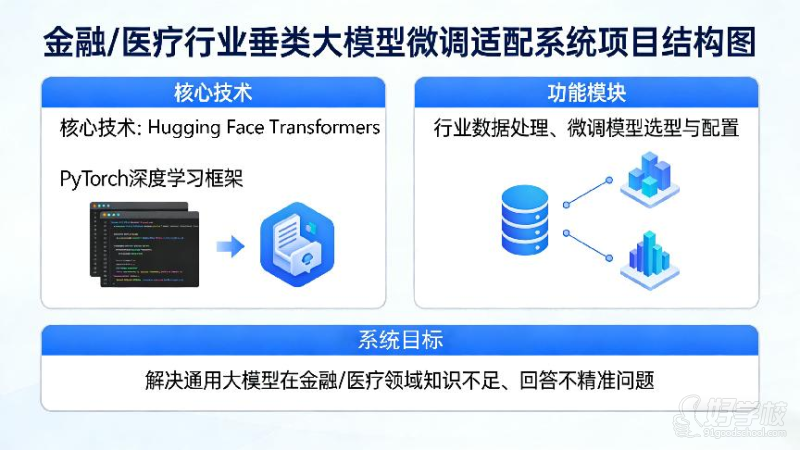
项目三、金融/医疗行业垂类大模型微调适配系统
【项目简介】
针对通用大模型在金融、医疗等专业领域的知识不足、回答不精准问题,打造行业垂类大模型微调适配系统,基于开源通用大模型,完成金融研报分析、医疗病历解读等垂类场景的定制化微调,实现从领域数据处理到模型微调、效果评估的全流程落地,输出可直接应用于行业场景的轻量垂类大模型,解决通用大模型的行业适配性问题。
【核心技术】
HuggingFaceTransformers/ModelScope大模型开发框架、PyTorch深度学习框架、DeepSpeed 分布式训练优化、SFT监督微调技术、DPO直接偏好优化技术、金融/医疗领域数据清洗与标准化、大模型效果量化评估体系、GPU算力调度与显存优化、Llama/Qwen开源大模型适配、Matplotlib/Seaborn可视化分析。
【功能实现】
1.行业数据处理:收集金融研报/医疗病历等领域原始数据,完成数据去重、低质量内容过滤、敏感信息脱敏,实现数据格式标准化与Prompt模板构造;
2.微调模型选型与配置:支持Llama、Qwen等主流开源通用大模型接入,配置微调参数(学习率、批次大小、训练轮次),基于DeepSpeed实现分布式训练,提升微调效率;
3.多策略模型微调:先通过SFT监督微调让模型学习行业领域知识,再通过DPO直接偏好优化提升模型回答的专业性与准确性,解决SFT微调后的模型偏好问题;
4.微调过程监控:实时监控训练过程中的损失值、准确率等指标,通过可视化图表展示训练趋势,支持训练过程中断与续跑;
5.模型效果量化评估:设计行业专属评估指标(如金融研报分析准确率、医疗病历解读契合度),结合自动化测评与人工测评,完成微调模型与通用模型的效果对比;
6.轻量模型输出:对微调后的模型进行轻量化处理,输出可直接部署的行业垂类大模型,提供模型推理接口与使用文档。
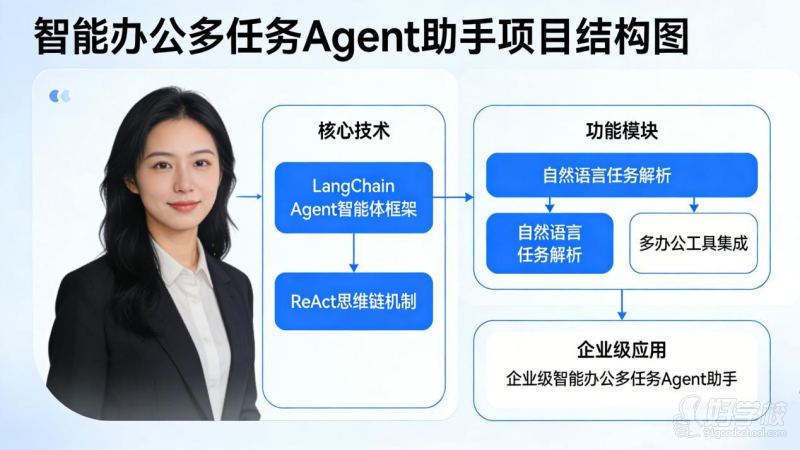
项目四、智能办公多任务Agent助手
【项目简介】
基于LangChainAgent框架打造企业级智能办公多任务Agent助手,集成办公场景下的多工具能力,实现自然语言指令驱动的自动化办公,支持任务拆解、自主执行、结果反馈与修正,适配企业日常办公、行政事务、数据统计等场景,替代人工完成重复性办公任务,提升企业办公效率,打造智能办公助手。
【核心技术】
LangChainAgent智能体框架、ReAct思维链机制、大模型(OpenAI/ChatGLM)语义理解与任务拆解、SerpAPI网页信息检索、PythonREPL数据计算、Outlook/企业微信API第三方工具集成、Redis对话记忆存储、Streamlit可视化界面开发、多任务并行处理机制、工具调用结果解析与修正技术。
【功能实现】
1.自然语言任务解析:接收用户自然语言办公指令,通过大模型完成任务意图识别与多步骤任务拆解,生成可执行的工具调用流程;
2.多办公工具集成:集成邮件处理(发送、接收、批量筛选)、日程管理(创建、修改、提醒)、文档生成/解析(Word/Excel自动化)、数据统计(表格计算、图表生成)、网页信息检索等工具能力;
3.自主工具调用与执行:Agent根据拆解后的任务流程,自主选择并调用对应工具,完成多步骤办公任务的自动化执行,支持多任务并行处理;
4.对话记忆与连续交互:通过Redis存储历史对话与任务执行记录,支持多轮连续的办公指令交互,记忆用户使用习惯与任务上下文;
5.结果反馈与修正:任务执行完成后,向用户反馈执行结果与相关文件/链接,若执行结果不符合需求,支持用户自然语言修正,Agent重新执行任务;
6.可视化操作界面:基于Streamlit开发轻量化可视化界面,支持指令输入、任务执行状态查看、结果导出,操作简单易上手;
7.办公数据管理:支持任务执行结果、生成文档、统计数据的批量保存与分类管理,实现办公数据的归集。
项目五、企业级大模型推理服务高可用平台
【项目简介】
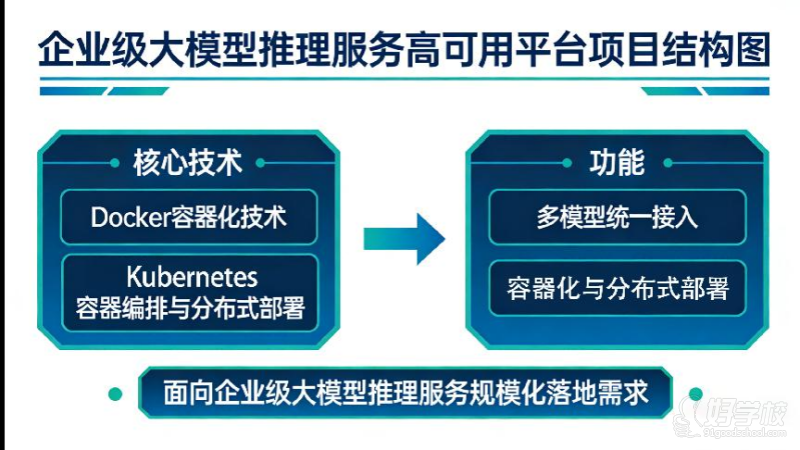
本项目面向企业级大模型推理服务的规模化落地需求,打造大模型推理服务高可用平台,解决大模型部署过程中的兼容性、高并发、稳定性等问题,实现多开源大模型的统一接入、容器化部署与分布式管理,集成推理优化、服务监控、异常告警等能力,推理服务7×24 小时稳定运行,适配企业大模型应用的规模化推广场景。
【核心技术】
Docker容器化技术、Kubernete(sK8s)容器编排与分布式部署、FastAPI/TritonInferenceServer大模型推理服务框架、Nginx反向代理与负载均衡、GPTQ/AWQ大模型量化技术、TensorRT 推理加速Prometheus+Grafana监控告警、ELK日志收集与分析、多模型统一接口标准化、服务自动扩缩容与故障恢复机制
【功能实现】
1.多模型统一接入:支持Qwen、ChatGLM、Llama等主流开源大模型的一键接入,实现模型文件的统一管理与版本控制;
2.容器化与分布式部署:基于Docker完成大模型与推理服务的容器打包,通过K8s实现多节点分布式部署,支持服务的弹性扩缩容,根据请求量自动增减节点;
3.推理服务优化:通过GPTQ/AWQ量化技术与TensorRT推理加速,降低模型显存占用,提升推理速度,兼顾推理效果与效率;
4.标准化接口封装:基于FastAPI/TritonInferenceServer实现推理服务的标准化接口封装,支持同步/异步请求,适配企业各类应用的接口调用需求;
5.高并发处理:通过Nginx实现反向代理与负载均衡,将用户请求均匀分发至各个推理节点,支持万级并发请求处理;
6.全维度监控告警:基于Prometheus+Grafana实现对推理服务的QPS、响应延迟、显存占用、GPU利用率等指标的实时监控,设置阈值告警,通过邮件/企业微信推送异常信息;
7.日志与故障排查:基于ELK栈实现推理服务日志的全量收集、存储与分析,支持日志检索与可视化,定位服务故障原因;
8.服务高可用:实现服务健康检查与自动故障恢复,若某个推理节点故障,自动将请求切换至正常节点,推理服务不间断运行。
项目六、大模型效果评估与调优系统
【项目简介】
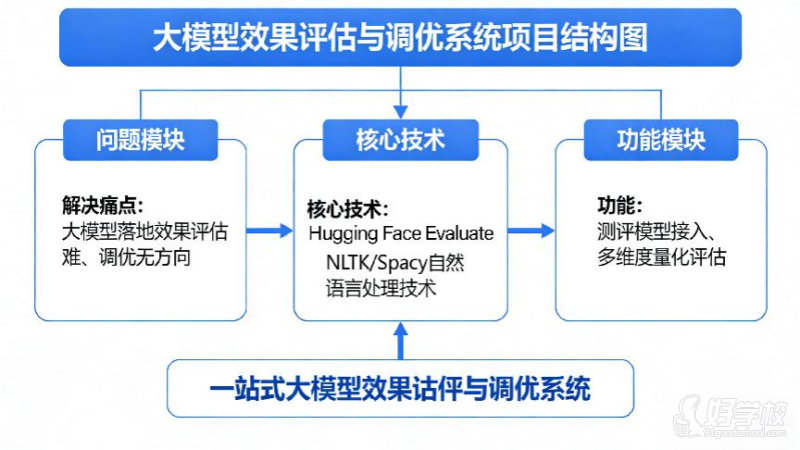
针对大模型落地过程中的效果评估难、调优无方向问题,大模型效果评估与调优系统,设计多维度、可量化的大模型评估体系,支持对通用大模型、行业微调模型的全方位测评,结合自动化与人工测评输出专业评估报告,并针对模型问题给出针对性的调优建议,适配大模型选型、微调优化、落地应用前的效果检测等场景
【核心技术】
HuggingFaceEvaluate评估框架、NLTK/Spacy自然语言处理技术、大模型多维度评估指标体系、自动化测评数据集构建、人工测评流程设计、Pandas数据统计分析、Matplotlib/Seaborn 可视化、LangChain提示词工程、大模型推理参数调优技术、微调策略优化建议模型。
【功能实现】
1.测评模型接入:支持本地/私有化部署的通用大模型、行业微调模型的一键接入,适配Qwen、ChatGLM、Llama等主流模型;
2.多维度量化评估:从问答准确率、文本生成质量、推理能力、垂类适配性、上下文理解、抗幻觉能力等维度设计量化评估指标,实现对模型的全方位测评;
3.自动化测评:构建通用/行业专属自动化测评数据集,自动向模型发起测试请求,收集回答结果并进行智能评分,输出自动化测评结果;
4.人工测评流程:提供人工测评界面,支持测评人员对模型回答进行打分与点评,实现自动化与人工测评的结合,提升测评准确性;
5.测评报告生成:自动整合自动化与人工测评数据,通过可视化图表展示模型各维度表现,输出专业的大模型效果评估报告,明确模型优势与不足;
6.针对性调优建议:根据模型测评结果,针对模型存在的问题,给出提示词优化、推理参数(温度、top_p)调优、SFT/DPO微调策略优化等具体建议;
7.调优效果验证:支持调优方案的验证,将调优后的模型重新接入系统进行测评,对比调优前后的模型效果,验证调优有效性。
项目七、边缘端轻量化大模型部署与应用系统
【项目简介】
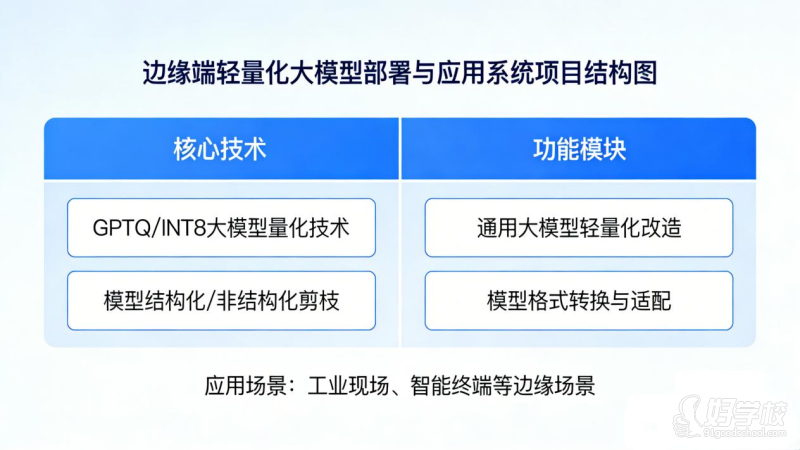
针对工业现场、智能终端等边缘场景的大模型应用需求,打造边缘端轻量化大模型部署与应用系统,解决通用大模型显存占用高、推理速度慢、无法在边缘设备运行的问题,通过模型量化、剪枝等技术完成通用大模型的轻量化改造,实现边缘端大模型的本地推理与离线应用,兼顾推理速度与效果,适配工业现场智能问答、智能终端离线助手等边缘场景。
【核心技术】
GPTQ/INT8大模型量化技术、模型结构化剪枝、非结构化剪枝、ONNXRuntime跨平台推理框架、TensorRT推理加速、PyTorchMobile边缘端适配、边缘端Linux系统优化、FastAPI 轻量级接口开发、边缘设备硬件资源适配、大模型离线推理技术、轻量化模型效果优化。
【功能实现】
1.通用大模型轻量化改造:选择Qwen/ChatGLM等轻量通用大模型,通过GPTQ/INT8量化技术降低模型显存占用,结合剪枝技术去除模型冗余参数,完成模型轻量化处理;
2.模型格式转换与适配:将轻量化后的模型转换为ONNX格式,基于ONNXRuntime与TensorRT实现边缘端推理加速,适配边缘设备(工控机、边缘服务器)的硬件架构;
3.边缘端环境搭建:完成边缘端Linux系统的优化、GPU/CPU驱动安装、推理依赖库配置,实现轻量化模型的边缘端本地部署,支持离线运行;
4.轻量级推理接口开发:基于FastAPI开发轻量化推理接口,适配边缘设备的低资源特性,支持自然语言问答、轻量级文本生成等基础功能的接口调用;
5.边缘端离线应用:实现大模型在边缘端的本地离线推理,无需连接公有云,支持工业现场知识问答、设备故障咨询、智能终端离线文本生成等场景;
6.推理效果与速度优化:针对边缘设备硬件资源,调整推理参数,平衡模型推理效果与速度,边缘端应用的流畅性;
7.模型本地更新:支持轻量化模型的本地增量更新与版本替换,无需重新部署整个系统,适配边缘场景的模型迭代需求。
项目八、大模型驱动的客户智能交互系统(智能客服)
【项目简介】
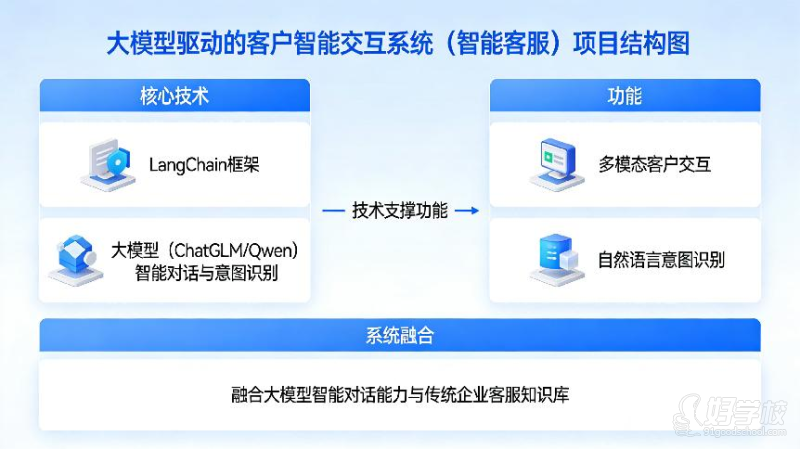
融合大模型智能对话能力与传统企业客服知识库,打造大模型驱动的客户智能交互系统(智能客服),替代人工完成大部分客户咨询工作,解决传统智能客服话术僵硬、无法处理复杂问题的痛点,支持多轮智能对话、语音/文字多模态交互,适配电商、金融、政务等行业的客户服务场景,提升客户服务效率与体验,降低企业客服成本。
【核心技术】
LangChain框架、大模型(ChatGLM/Qwen)智能对话与意图识别、Faster-Whisper语音识别技术、TTS语音合成技术、传统客服知识库融合技术、MySQL/Redis知识库存储、FastAPI 接口开发、Vue.js前端交互界面开发、客户意图分类与问题匹配、未解决问题人工转派机制。
【功能实现】
1.多模态客户交互:支持文字、语音两种交互方式,客户语音咨询可通过Faster-Whisper 转换为文字,模型回答可通过TTS转换为语音,实现全流程语音交互;
2.自然语言意图识别:接收客户咨询内容,通过大模型完成客户意图识别与问题分类,匹配客服知识库中的相关答案;
3.多轮智能对话:融合大模型对话能力与客服知识库,支持复杂问题的多轮连续对话,记忆客户历史咨询内容,实现个性化的客户解答;
4.智能问题解答:针对客户常见问题,自动匹配知识库答案并进行生成式优化,针对复杂问题,通过大模型结合知识库实现精准回答,避免通用大模型幻觉;
5.问题自动分类与转派:对于大模型与知识库无法解答的问题,自动将问题分类并转派至对应人工客服,同时将客户历史咨询内容同步给人工客服,实现无缝衔接;
6.客服知识库管理:支持客服知识库的批量上传、增量更新、内容删除,实现问题与答案的一键关联,支持知识库内容的模糊检索与精准匹配;
7.客户咨询数据统计:自动统计客户咨询量、问题分类、解答准确率、人工转派率等指标,通过可视化图表展示,为企业客服优化提供数据支撑;
8.前端交互界面开发:基于Vue.js开发简洁易用的前端交互界面,适配电脑、手机等多终端,支持客户在线咨询、咨询记录查看、满意度评价等功能。
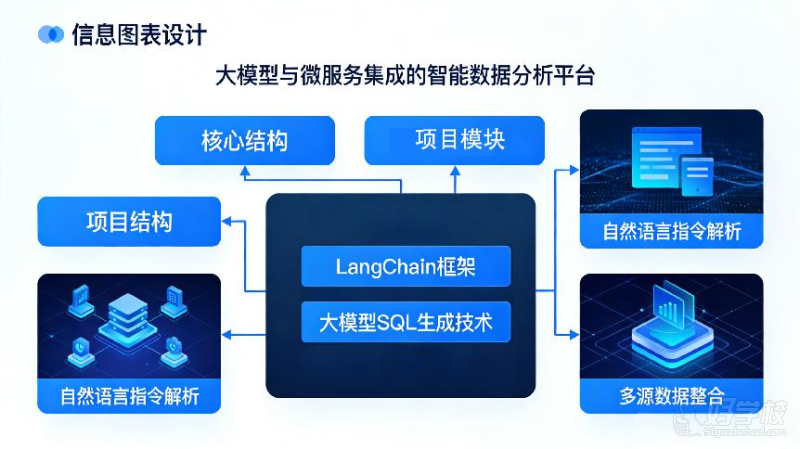
项目九、大模型与微服务集成的智能数据分析平台
【项目简介】
本项目实现大模型与企业微服务架构的深度融合,打造智能数据分析平台,解决企业传统数据分析需要专业技术人员、效率低的痛点,支持用户通过自然语言指令完成数据分析全流程操作,适配企业经营分析、业务数据监控、销售数据统计等场景,让非技术人员也能完成专业的数据分析工作,实现企业数据价值的高效挖掘。
【核心技术】
LangChain框架、大模型SQL生成技术、SpringBoot微服务架构、MySQL/ClickHouse数据仓库、FastAPI跨服务接口集成、ECharts/Matplotlib数据可视化、自然语言到SQL的解析与优化、多源数据整合技术、数据报告自动生成技术。
【功能实现】
1.自然语言指令解析:接收用户自然语言数据分析需求,通过大模型完成需求解析,自动生成符合语法规范的SQL查询语句,支持复杂多表关联、条件筛选、数据统计等查询需求;2.多源数据整合:集成企业MySQL/ClickHouse等多源数据仓库,实现跨数据源的统一查询与数据整合,支持企业经营、销售、运营等多维度数据的接入;
3.自动数据查询与统计:将生成的SQL语句自动发送至对应数据仓库,完成数据查询与统计分析,支持数据排序、分组、聚合等常见统计操作;
4.数据可视化生成:根据数据分析结果,自动生成多样化的可视化图表(柱状图、折线图、饼图、热力图等),支持图表样式自定义与导出;
5.智能数据报告撰写:结合数据分析结果与可视化图表,通过大模型自动生成结构化的数据分析报告,支持报告内容编辑、格式调整与一键导出(Word/PDF);
6.微服务架构集成:基于SpringBoot搭建微服务架构,将数据解析、查询、可视化、报告生成等功能拆分为独立微服务,通过FastAPI实现跨服务接口集成,提升系统可扩展性与稳定性;
7.自定义数据分析维度:支持用户自定义数据分析指标、时间范围、数据维度,实现个性化的数据分析需求,适配企业不同场景的数据分析要求;
8.数据权限管理:设置不同角色的数据分析权限,实现数据仓库的访问与操作权限管控,企业数据安全。
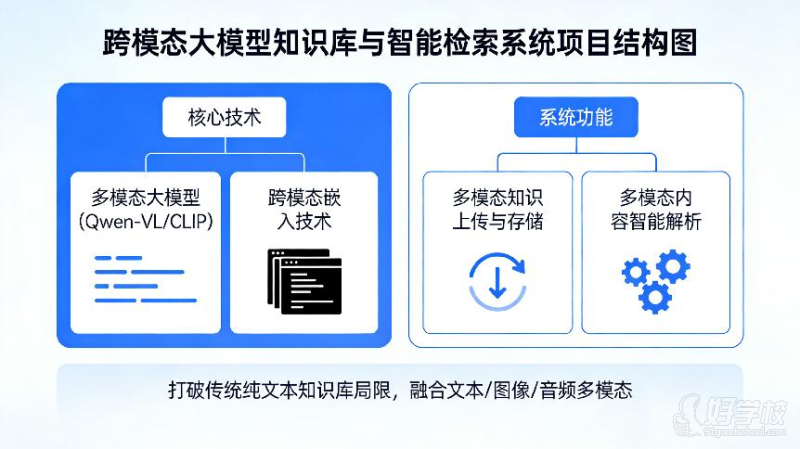
项目十、跨模态大模型知识库与智能检索系统
【项目简介】
本项目打破传统纯文本知识库的局限,打造融合文本、图像、音频的跨模态大模型知识库与智能检索系统,实现多模态知识的解析与智能检索,支持跨模态的混合检索与生成式解答,适配教育、医疗、文博等需要多模态资料管理与查询的场景,为用户打造沉浸式的多模态知识查询体验。
【核心技术】
多模态大模型(Qwen-VL/CLIP)、跨模态嵌入技术、Milvus多模态向量数据库、LangChain 流程编排、Faster-Whisper音频处理技术、PyTorch深度学习框架、Docker容器化部署、FastAPI 接口开发、MinIO分布式文件存储、跨模态相似性检索技术、多模态内容智能解析技术。
【功能实现】
1.多模态知识上传与存储:支持文本、图像、音频等多模态资料的批量上传,通过MinIO 实现分布式文件存储,完成多模态资料的结构化分类与管理;
2.多模态内容智能解析:对上传的多模态资料进行智能解析,提取文本核心信息、图像视觉特征、音频语音内容,完成多模态内容的结构化处理;
3.跨模态向量化嵌入:基于Qwen-VL/CLIP跨模态大模型,将文本、图像、音频转换为统一维度的向量,存储至Milvus多模态向量数据库,实现多模态知识的统一表示;
4.跨模态智能检索:支持以文搜图、以图搜文、以图搜音频、以音频搜文等跨模态混合检索方式,通过向量库完成相似性检索,定位相关多模态知识;
5.多模态生成式解答:接收用户自然语言问题,结合跨模态知识库的检索结果,通过多模态大模型实现生成式回答,支持结合图像、音频内容进行精准解答;
6.知识库增量更新与维护:支持多模态知识库的内容添加、删除、修改,实现向量库的增量更新,无需重新训练嵌入模型,提升知识库维护效率;
7.多模态知识预览与播放:支持知识库内图像的在线预览、音频的在线播放、文本的在线查看,实现多模态知识的预览;
8.私有化部署与安全管控:基于Docker完成系统整体容器化打包,支持企业私有化部署,设置用户访问权限,多模态知识数据的安全。

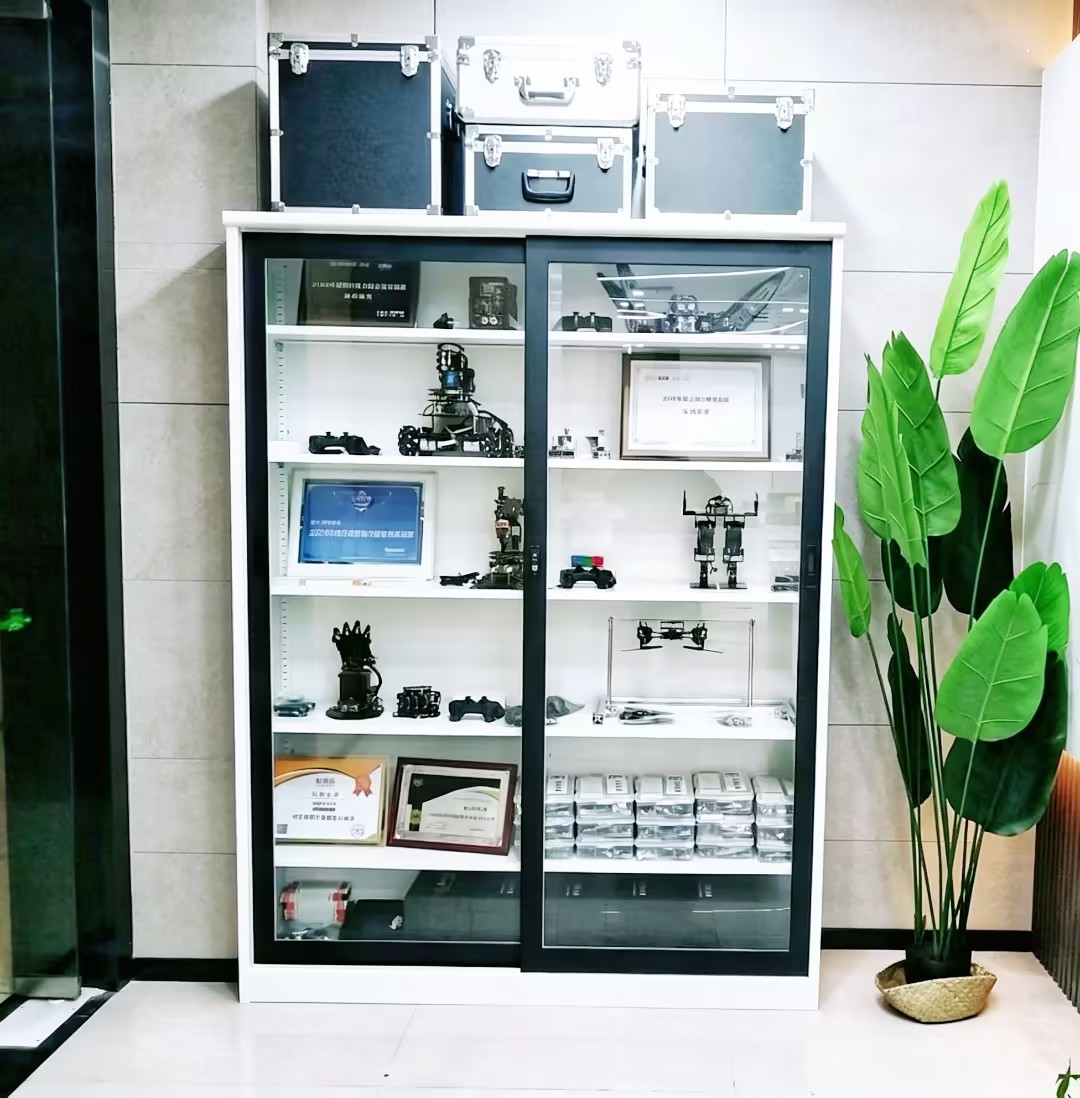 南京校区
 南京校区
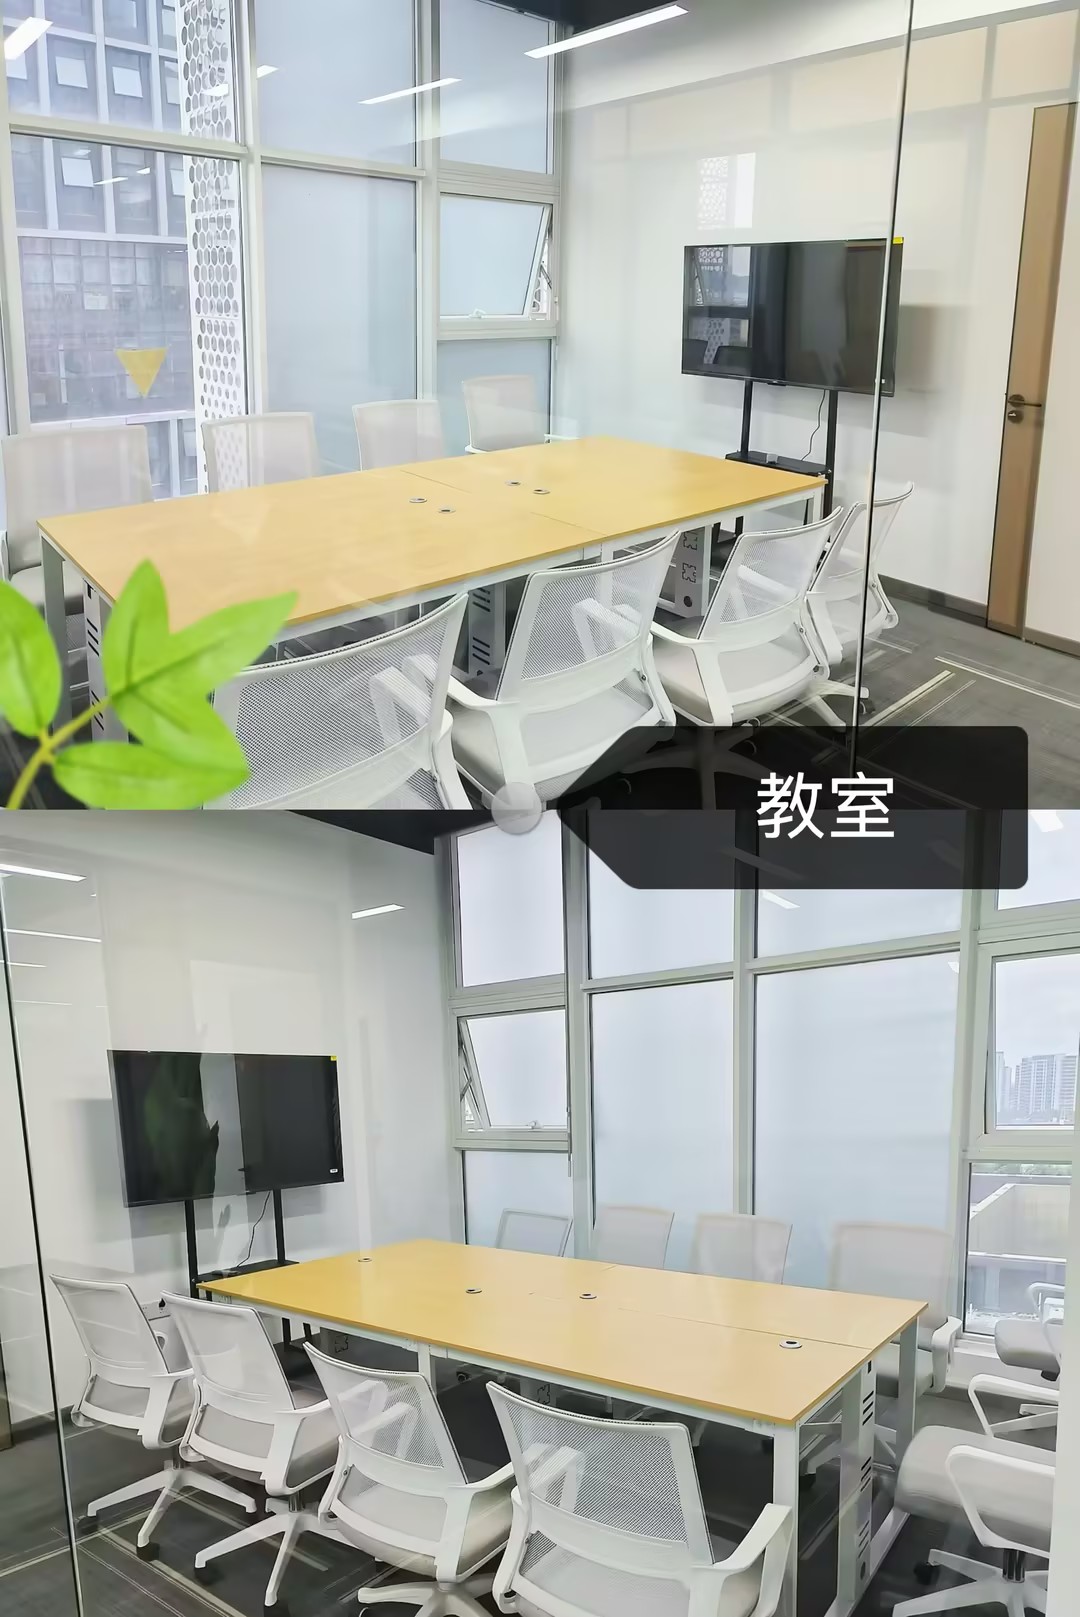 南京校区
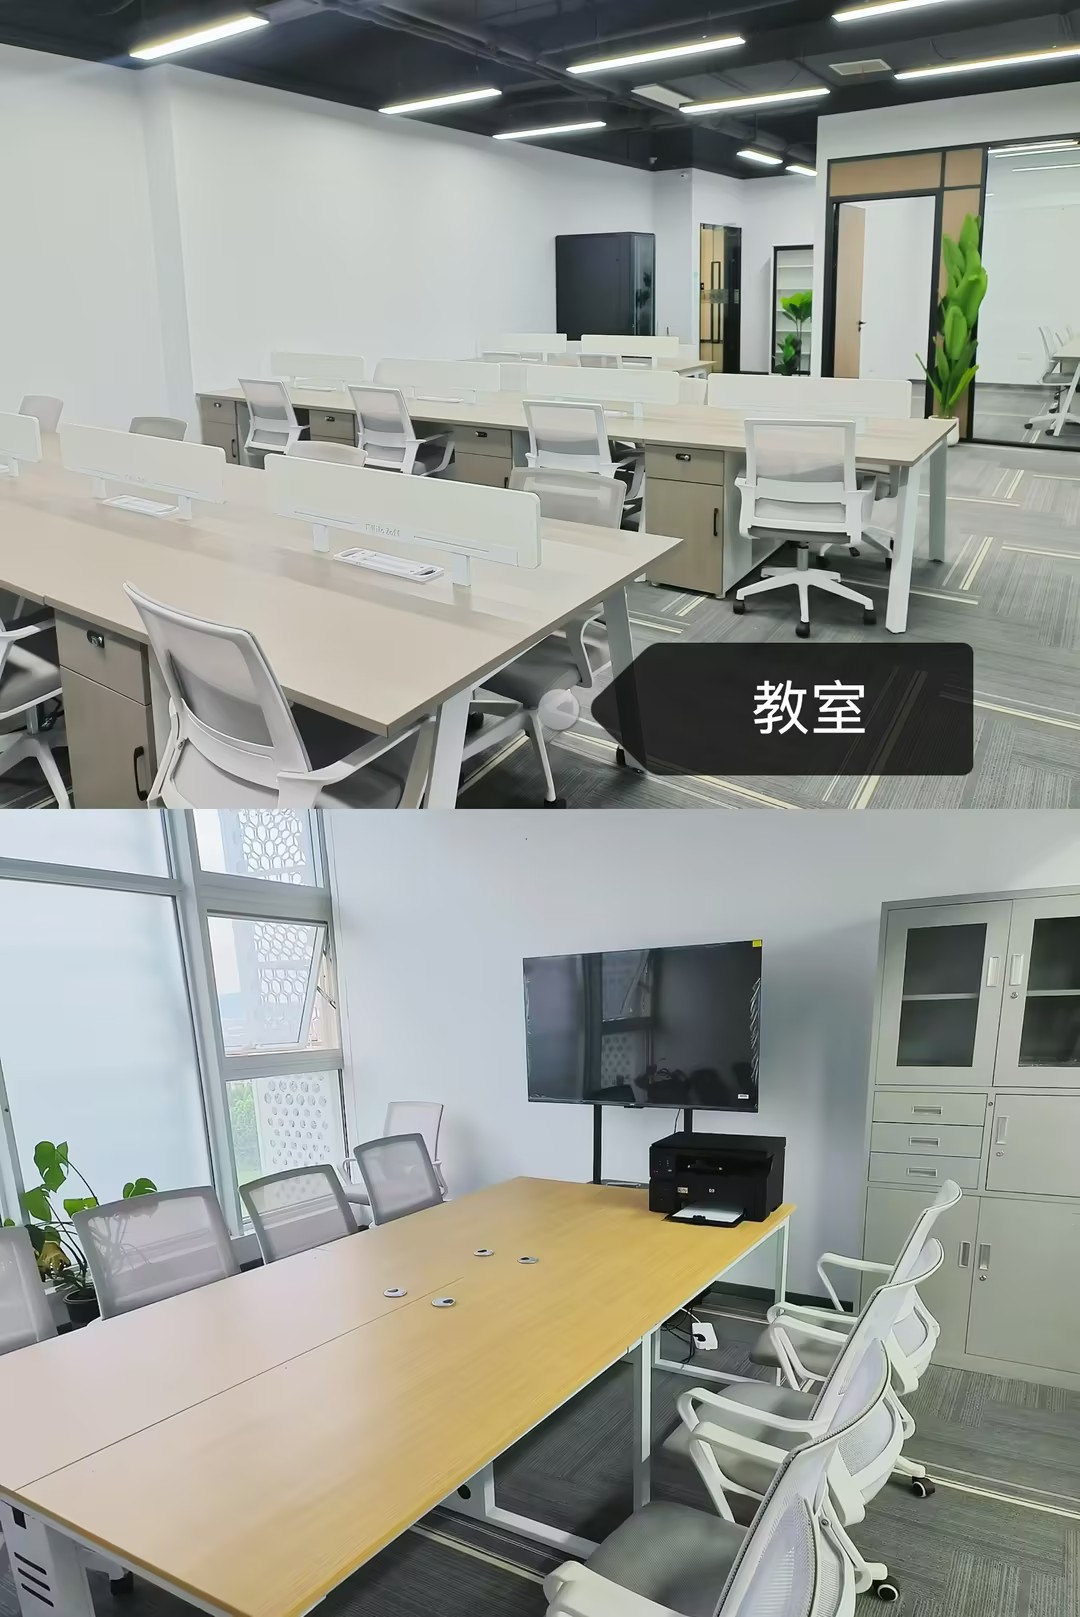 南京校区


 正规学校
 助学补贴
 优质服务